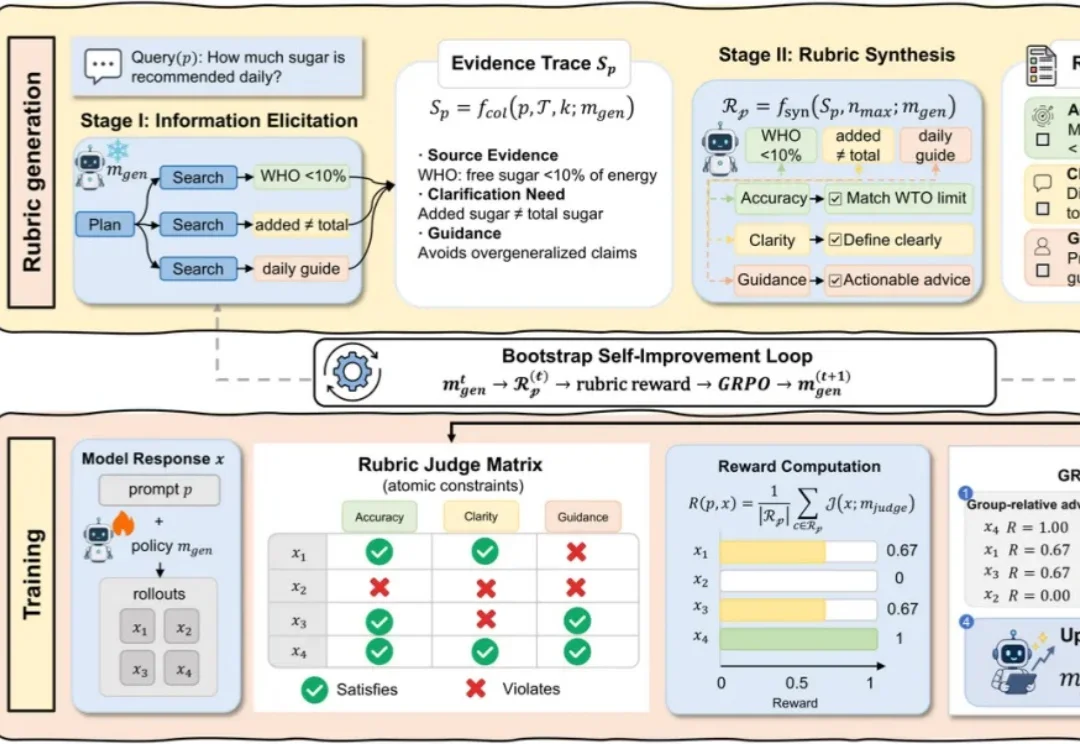
NeurIPS 2026|小红书 × 复旦大学用DR-Rubric为开放式强化学习构建评分标准
NeurIPS 2026|小红书 × 复旦大学用DR-Rubric为开放式强化学习构建评分标准让大模型回答一道数学题,通常还能拿标准答案判断对错。可如果问题换成「梳理一个领域的研究进展」「比较几种技术路线」或者「给出有依据的专业建议」,怎样才算答得好?答案没有唯一版本,遗漏关键事实、混淆概念、论证不充分,都可能藏在一段看起来很流畅的文字里。
搜索
让大模型回答一道数学题,通常还能拿标准答案判断对错。可如果问题换成「梳理一个领域的研究进展」「比较几种技术路线」或者「给出有依据的专业建议」,怎样才算答得好?答案没有唯一版本,遗漏关键事实、混淆概念、论证不充分,都可能藏在一段看起来很流畅的文字里。
厦门大学ASC Lab团队提出的FlowMAS获NeurIPS 2026录用,通过GFlowNet、好奇心驱动模块和信息引导优化模块自动生成多样且低成本的大模型多智能体工作流拓扑,并在六个基准实验中取得领先成绩。
STILL被NeurIPS 2026正式接收,这一首个内容感知的同层混合注意力架构通过自显著性分数按内容选择token,仅用0.04B训练token即在16K上下文下实现80%显存削减和83%预填充加速。
研究团队提出7B审计员AgentForesight,可在多智能体任务运行中在线识别并归因关键错误,其AFTraj-2K Exact-F1达66.44,成功轨迹误报率仅2.37%。
清华大学智能产业研究院(AIR)的一项NeurIPS 2026录用工作提出高阶动作监督,无需改动策略网络即可约束动作的一阶时序变化,并在OGBench及约1%数据的D4RL实验中提升小样本性能与动作平滑性。
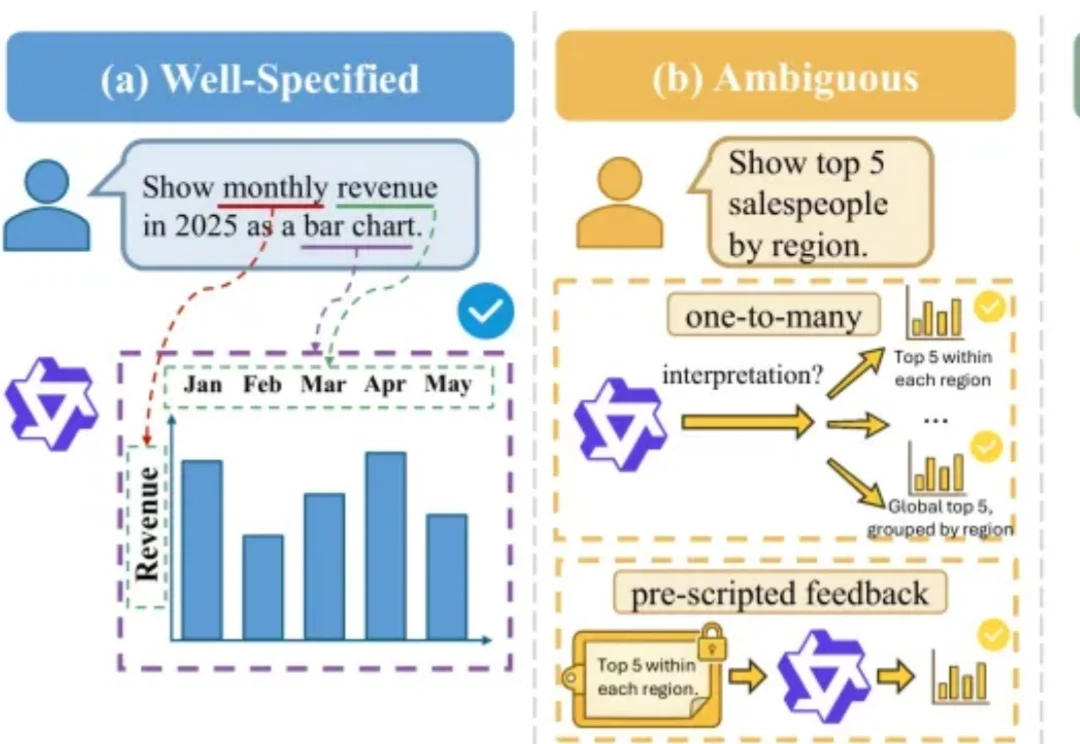
数据要让人看懂,通常得先从数据库里查出来,再画成图。文本到可视化(Text-to-Vis)做的就是这件事:用户说出想看什么,系统去库里查询,再用图表把需要的数据展示出来。
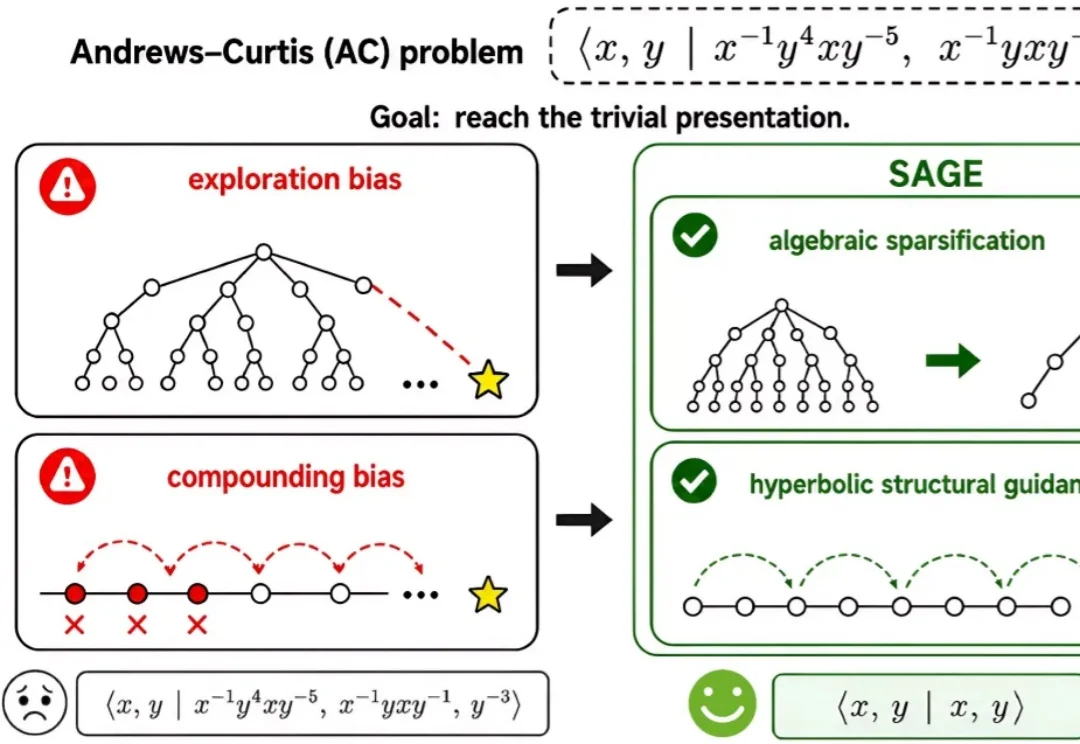
大模型解短题常能给出流畅答案,推理链一长,却可能每一步都看似合理、终点仍然失效。来自弗吉尼亚理工大学、威斯康星大学麦迪逊分校和达特茅斯学院的研究团队在 NeurIPS2026 论文中提出 SAGE:用符号闭包分析(SCA)解释长推理中的探索偏差与累积偏差,再把这一诊断变成训练时的结构引导。
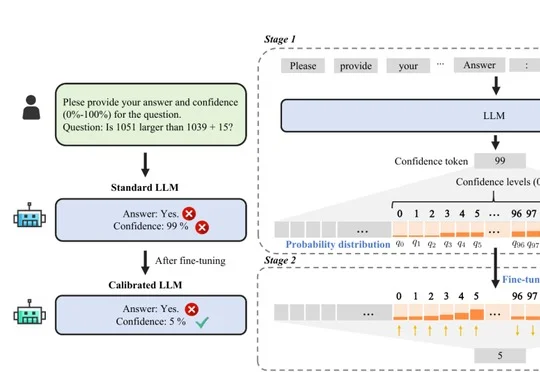
TypeSafe AI推出的Jev模型因直接输出决策与概率火爆出圈,其技术思路与NeurIPS 2025入选论文ConfTuner高度一致,后者通过Tokenized Brier Score直接训练候选置信度概率分布以实现概率校准。
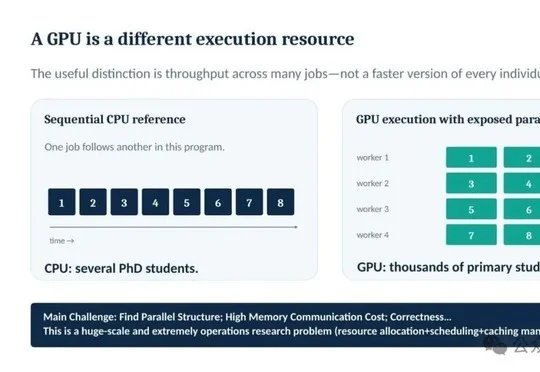
港科大团队在NeurIPS 2026上提出AccelEval基准,覆盖6个领域42项任务和43类CUDA优化策略,评测大模型能否从可信CPU程序生成端到端更快的GPU实现,其中Gemini 3.1 Pro在中规模通过正确性验证的任务上取得71.2倍几何平均加速比。
NeurIPS 2026 正在用 AI 检测器来判定「论文投稿是否使用 AI」,并作为拒稿的重要依据。